El robots.txt es un archivo de texto de unas pocas líneas que le dice a Google (y a cualquier otro robot) por dónde puede pasar en tu web y por dónde no. Es pequeño, pero un error en una sola línea puede dejar tu web entera fuera del radar del buscador.
Y lo contrario también pasa: mucha gente lo usa para algo que no hace. Bloquea una página en el robots.txt pensando que así desaparece de Google, y no desaparece.
En este artículo te explicamos qué es, qué hace y qué no, y cómo crearlo sin romper nada. Para que no se quede en teoría, lo hacemos con el robots.txt de nuestra propia web, línea a línea.
Qué es el robots.txt y para qué sirve
El robots.txt es un archivo de texto plano que vive en la raíz de tu web (por ejemplo, tudominio.com/robots.txt). Antes de rastrear una web, los robots de los buscadores lo leen para saber qué URL pueden visitar y cuáles no.
Piénsalo como el cartel de «Solo personal autorizado» de un edificio. No cierra ninguna puerta con llave: solo avisa. Los visitantes educados, como Googlebot, lo respetan. Los que vienen con malas intenciones, no.
Según Google, sirve sobre todo para gestionar el tráfico de los rastreadores: que no pierdan tiempo en zonas que no aportan nada (el panel de administración, el buscador interno, URL con parámetros) y no sobrecarguen tu servidor.
Rastrear no es lo mismo que indexar
Aquí está la confusión más cara del robots.txt, así que vamos despacio:
- Rastrear es que Google visite una página y lea su contenido.
- Indexar es que Google la guarde en su índice para poder mostrarla en los resultados.
El robots.txt solo controla lo primero. Google lo dice sin rodeos: el robots.txt «no es un mecanismo para mantener una página fuera de Google». Si bloqueas una URL pero otras webs la enlazan, Google puede indexarla igualmente. Aparecerá en los resultados sin descripción, porque no ha podido leerla.
Si lo que quieres es que una página no salga en Google, la herramienta es la etiqueta noindex o protegerla con contraseña. Y ojo: para que Google vea el noindex, tiene que poder rastrear la página. Si la bloqueas en el robots.txt, nunca llegará a leer esa etiqueta.
| Quiero… | Uso… |
|---|---|
| Que Google no pierda tiempo en una zona de la web | Disallow en el robots.txt |
| Que una página no aparezca en Google | Etiqueta noindex (y dejarla rastrear) |
| Que nadie pueda ver una página | Contraseña en el servidor |
| Que Google encuentre todas mis páginas importantes | Un sitemap declarado en el robots.txt |
Un ejemplo real: nuestro robots.txt, línea a línea
La mejor forma de entenderlo es ver uno de verdad. Este es el de aupa.digital, tal cual lo puedes ver en aupa.digital/robots.txt:
# robots.txt · aupa.digital
# No se bloquean /wp-content/ ni /wp-includes/: Google necesita CSS, JS e imágenes para renderizar.
# Los rastreadores de IA quedan permitidos a propósito (SEO para IA).

User-agent: *
# Administración
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /wp-login.php
Disallow: /xmlrpc.php

# Búsqueda interna
Disallow: /?s=
Disallow: /*?s=
Disallow: /search/

# Feeds RSS
Disallow: /feed/
Disallow: /*/feed/

# Parámetros sin valor para el buscador
Disallow: /*?replytocom=
Disallow: /*&replytocom=

Sitemap: https://aupa.digital/sitemap_index.xml
(Al final declaramos también los sitemaps de entradas, páginas, casos, categorías y SEO local; aquí dejamos solo el índice para no alargarlo.)
Qué hace cada bloque:
- Las líneas con
#son comentarios. Google las ignora. Sirven para que quien toque el archivo dentro de un año sepa por qué está cada cosa. Te recomendamos usarlos siempre. User-agent: *significa «estas reglas valen para todos los robots». Como no hay grupos para robots concretos, todos siguen las mismas.- Administración. Bloqueamos el panel de WordPress (
/wp-admin/), el acceso (/wp-login.php) yxmlrpc.php. Ninguna de esas URL tiene nada que mostrar en Google. Pero dejamos pasaradmin-ajax.phpcon unAllow, porque algunas funciones de la parte pública de la web lo usan. - Búsqueda interna. Cada búsqueda en tu web genera una URL nueva (
/?s=zapatos,/?s=zapatos+rojos…). Son infinitas y no aportan nada que no esté ya en tus páginas. - Feeds RSS. Repiten el contenido de los posts en otro formato. No hace falta que Google los rastree.
replytocom. Es un parámetro que WordPress añade a los enlaces de «Responder» de los comentarios y que crea copias de la misma página.Sitemap:le dice a cualquier robot dónde está el mapa de todas las URL que sí queremos que encuentre.
Y tan importante como lo que bloqueamos es lo que no bloqueamos:
/wp-content/y/wp-includes/. Ahí están el CSS, el JavaScript y las imágenes. Google necesita esos archivos para ver la página como la ve una persona. Bloquearlos era una costumbre de hace años que hoy perjudica.- Los rastreadores de IA. Los dejamos pasar a propósito, porque queremos que ChatGPT, Gemini o Copilot puedan leernos y citarnos. Lo vemos más abajo.
Las directivas: qué entiende Google y qué ignora
Google solo admite cuatro instrucciones en el robots.txt. Todo lo demás lo ignora, aunque lo veas en muchos archivos copiados de internet. Así lo recoge su especificación oficial:
| Directiva | Para qué sirve | Ejemplo | ¿Google la respeta? |
|---|---|---|---|
User-agent | Dice a qué robot van las reglas que siguen | User-agent: Googlebot | Sí |
Disallow | Pide no rastrear una ruta | Disallow: /carrito/ | Sí |
Allow | Permite una ruta dentro de otra bloqueada | Allow: /carrito/ayuda/ | Sí |
Sitemap | Indica dónde está el sitemap | Sitemap: https://tudominio.com/sitemap.xml | Sí |
Crawl-delay | Pide esperar unos segundos entre visita y visita | Crawl-delay: 10 | No (otros buscadores, como Bing, sí) |
Noindex | Pretendía desindexar desde el robots.txt | Noindex: /privado/ | No. Usa la etiqueta noindex en la página |
Si prefieres oírlo de Google, aquí lo explica en un vídeo corto (en inglés):
Comodines: el asterisco y el dólar
Dos símbolos te ahorran escribir decenas de líneas:
*vale por «cualquier cosa».Disallow: /*?s=bloquea cualquier URL que contenga?s=, esté donde esté.$marca el final de la URL.Disallow: /*.pdf$bloquea todas las URL que terminen en.pdf.
Cuando dos reglas chocan
Si una URL encaja con un Disallow y con un Allow a la vez, Google aplica la regla más específica, que es la de la ruta más larga. Por eso en nuestro archivo Allow: /wp-admin/admin-ajax.php gana a Disallow: /wp-admin/. Si las dos tienen la misma longitud, gana la menos restrictiva, es decir, el Allow.
Tres detalles que conviene saber
- Las rutas distinguen mayúsculas de minúsculas.
Disallow: /Blog/no bloquea/blog/. - Cada subdominio necesita el suyo. El robots.txt de
www.tudominio.comno sirve paratienda.tudominio.com. - Google lo guarda en memoria hasta 24 horas. Si lo cambias, no esperes que el efecto sea inmediato.
Cómo crear tu robots.txt paso a paso
Antes de nada, comprueba si ya tienes uno: escribe tudominio.com/robots.txt en el navegador. Si usas WordPress, lo más probable es que exista aunque nunca lo hayas tocado, porque WordPress genera uno básico por defecto.
- Decide qué no quieres que se rastree. Piensa en zonas sin valor para el buscador: administración, carrito, buscador interno, páginas de pruebas. Si dudas con algo, no lo bloquees.
- Escríbelo en un editor de texto plano, como el Bloc de notas. Nada de Word: el archivo tiene que ser texto plano en UTF-8.
- Llámalo exactamente
robots.txt, en minúsculas. - Súbelo a la raíz del dominio:
tudominio.com/robots.txt. Si lo pones en una carpeta (tudominio.com/blog/robots.txt), los robots no lo buscarán ahí. - Añade la línea
Sitemap:con la URL completa de tu sitemap. - Compruébalo en Search Console (te contamos cómo justo debajo).
Si tu web está en WordPress con Rank Math o Yoast, no hace falta subir nada por FTP: los dos plugins traen un editor de robots.txt en sus ajustes. Y si tu web está en una plataforma como Wix o Shopify, puede que no te dejen editarlo directamente y que lo gestionen con sus propias opciones.
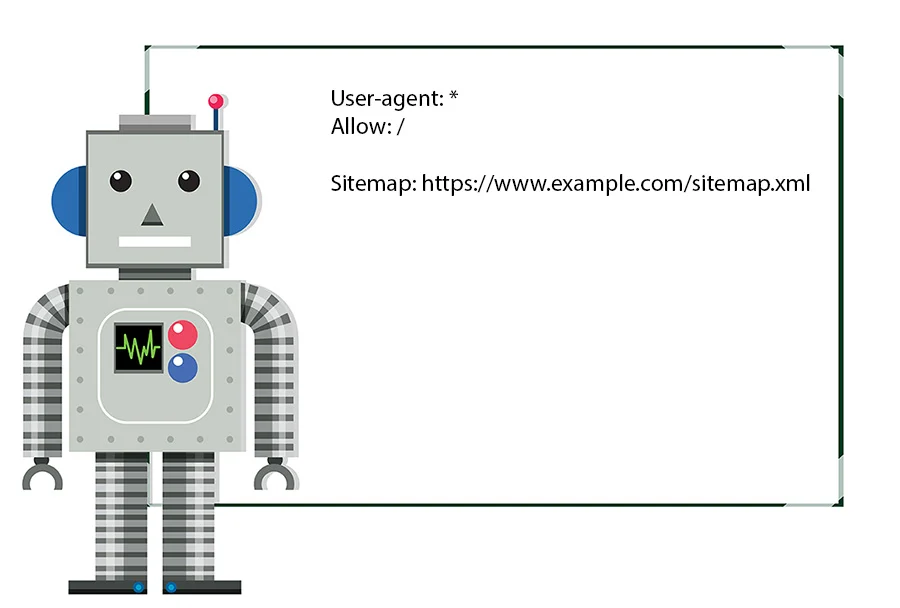
Un robots.txt mínimo y seguro para la mayoría de webs pequeñas cabe en tres líneas:
User-agent: *
Disallow:

Sitemap: https://tudominio.com/sitemap.xml
Un Disallow: vacío significa «no bloqueo nada». Para una web corporativa con un blog suele bastar: Google rastrea sin problema unos pocos cientos de URL. Afinar el robots.txt empieza a importar en webs grandes, como una tienda online con miles de productos y filtros.
Robots.txt y rastreadores de IA: ¿bloquear o dejar pasar?
Esta es la pregunta que más nos hacen ahora. Cada empresa de IA tiene su propio robot, y el robots.txt es donde decides si les dejas leer tu web. Lo importante es saber qué controla cada uno, porque no todos hacen lo mismo:
Robot (User-agent) | De quién es | Qué controla si lo bloqueas |
|---|---|---|
Googlebot | El rastreo para la Búsqueda, incluidos los resúmenes de IA y el Modo IA. Bloquearlo te saca de Google | |
Google-Extended | Si tu contenido se usa para entrenar Gemini y para responder en apps como Gemini. No afecta a tu presencia ni a tu posición en la Búsqueda | |
GPTBot | OpenAI | Si tu contenido se usa para entrenar sus modelos |
OAI-SearchBot | OpenAI | Si puedes aparecer como fuente en las búsquedas de ChatGPT |
bingbot | Microsoft | El rastreo de Bing, del que tira Copilot |
Dos ideas que se suelen mezclar:
- Para salir en los resúmenes de IA de Google no hay un robot aparte. Google explica en su guía sobre funciones de IA que basta con que la página esté indexada y pueda mostrarse con fragmento. Se controla con
Googleboty con las etiquetas de fragmento (nosnippet,max-snippet), no conGoogle-Extended. - Bloquear el entrenamiento no es lo mismo que bloquear las respuestas. Puedes decir «no entrenes con mi web» y, a la vez, seguir permitiendo que te citen como fuente.
Si decidieras no ceder tu contenido para entrenar modelos, sin dejar de aparecer en Google ni en ChatGPT, lo harías así:
User-agent: Google-Extended
Disallow: /

User-agent: GPTBot
Disallow: /
Nosotros no lo hacemos. Nuestro trabajo es que las IA conozcan y citen a nuestros clientes, así que en nuestra web dejamos pasar a todos. Para una empresa que vive de que la encuentren, cerrar la puerta a las IA suele restar más de lo que protege. Si quieres profundizar, es justo lo que trabajamos en SEO para IA.
Un apunte de última hora: en octubre de 2026 Google anunció que en 2027 quiere admitir una señal común en el robots.txt para gestionar el entrenamiento de varias IA a la vez. Te lo contaremos cuando esté en marcha.
Cómo comprobarlo en Search Console
No publiques un robots.txt sin revisarlo. Search Console tiene un informe de robots.txt que te dice qué archivo ha encontrado Google, cuándo lo leyó por última vez y si tiene errores. Lo encontrarás en Ajustes, dentro del apartado de rastreo.
Para cada archivo verás:
- Estado de obtención: si Google lo pudo descargar o no.
- Fecha de comprobación: la última vez que lo leyó.
- Problemas: los errores hacen que Google ignore esa regla; las advertencias, no.
Si acabas de corregir algo importante (por ejemplo, desbloquear una sección que no debía estar bloqueada), desde los tres puntos de ese archivo puedes pedir que lo vuelva a leer con Solicitar nuevo rastreo.
El informe solo está disponible en propiedades de dominio.
Para una página concreta, usa la Inspección de URLs: te dice si el robots.txt le está impidiendo el paso a Google.
Los errores que más vemos al revisar webs
Cuando hacemos una auditoría SEO, el robots.txt es de lo primero que miramos. Estos son los fallos que más se repiten:
- Publicar la web nueva con el
Disallow: /de pruebas. Mientras se construye una web, es normal bloquearla entera. El problema llega cuando se publica y nadie quita esa línea: Google deja de rastrear todo el sitio. Es uno de los errores típicos de una migración mal hecha. - Bloquear una página para sacarla de Google. Ya lo hemos visto: si tiene enlaces, puede seguir apareciendo. Para eso está el
noindex. - Poner
noindexy bloquearla a la vez. Google no puede leer elnoindexde una página que no le dejas visitar, así que la etiqueta no sirve de nada. - Bloquear CSS, JavaScript o imágenes. Google ve la página rota y le cuesta entenderla.
- Que el robots.txt dé error de servidor. Si al pedirlo la web responde con un error 5xx, Google deja de rastrear tu web entera durante las primeras 12 horas, según su especificación. Un fallo del servidor en ese archivo pesa más de lo que parece.
- Copiar el robots.txt de otra web. Cada web tiene sus rutas. Lo que bloquea en una tienda puede dejar fuera tu blog en otra.
- Olvidar el
Sitemap:. No rompe nada, pero es la forma más sencilla de que cualquier buscador encuentre todas tus páginas importantes.
Preguntas frecuentes sobre el robots.txt
¿Es obligatorio tener un robots.txt?
No. Si no existe, Google entiende que puede rastrearlo todo. Aun así, conviene tenerlo, aunque sea mínimo, para declarar el sitemap.
¿El robots.txt mejora mi posicionamiento?
No directamente. Lo que hace es ayudar a que Google dedique su tiempo a las páginas que importan. En webs pequeñas el efecto es mínimo; en webs grandes puede marcar la diferencia.
¿Cuánto tarda Google en ver los cambios?
Google suele guardar el archivo hasta 24 horas. Si el cambio es urgente, pide un nuevo rastreo desde el informe de robots.txt de Search Console.
¿Puedo usar el robots.txt para ocultar información privada?
No. El archivo es público: cualquiera puede leerlo y ver qué rutas estás intentando esconder. Lo privado se protege con contraseña.
¿Si bloqueo GPTBot desaparezco de ChatGPT?
No exactamente. GPTBot controla el entrenamiento. Para aparecer como fuente en las búsquedas de ChatGPT, el que cuenta es OAI-SearchBot, según la documentación de OpenAI.
En resumen
Un buen robots.txt es corto, está comentado y solo bloquea lo que no aporta nada. Lo más importante es no pedirle lo que no hace: no saca páginas de Google ni protege nada privado.
Si no tienes claro si el tuyo está ayudando o frenando a tu web, es de lo primero que revisamos. Empezamos siempre con una reunión gratuita de 30 minutos para entender tu proyecto. Hablemos.
Fuentes
- Google Search Central: Introducción a robots.txt
- Google: Cómo interpreta Google la especificación de robots.txt
- Google: Crear y enviar un archivo robots.txt
- Google: Rastreadores comunes de Google (Google-Extended)
- Google Search Central: Funciones de IA y tu sitio web
- Ayuda de Search Console: Informe de robots.txt
- OpenAI: Rastreadores de OpenAI
Deja un comentario